Beam 权重上线:不拼每个 token 更便宜,拼一件事少烧多少 token
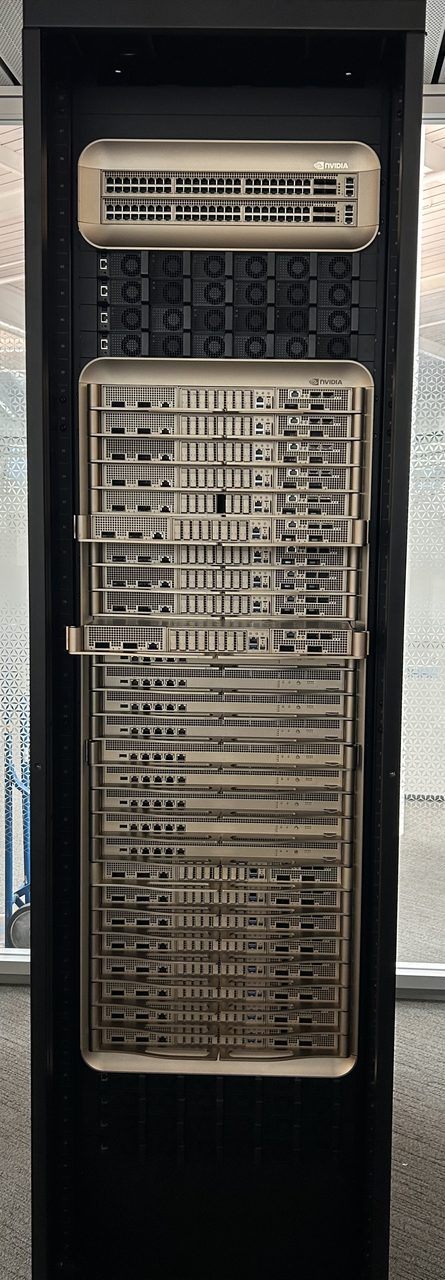
图片:NVIDIA, CC BY-SA 4.0, via Wikimedia Commons · via Wikimedia Commons
Beam 权重上线:不拼每个 token 更便宜,拼一件事少烧多少 token
501B 权重上线,每次只叫醒 23B
10 月 16 日,Reflection AI 把首个开放权重模型 Beam 的权重放上 Hugging Face,标注 Apache 2.0 许可。它是一个稀疏混合专家(MoE)模型:总参数 5010 亿,每生成一个 token 只激活 230 亿,约 22 个参数里 1 个在干活。上下文窗口 100 万 token,提供 BF16、FP8、NVFP4 三档权重,外加 DFlash2 草稿模型、分词器和一套 Rust 写的 Mirror 工具链。10 月 5 日首发时它还在红队测试阶段、只能走候补名单;这次是真正可下载。
卖效率不卖跑分,自报省三到四倍算力
Reflection 的说法是,Beam 在高级推理测试上达到"与 GLM-5.2 相当"的水平,而推理算力只用后者的三分之一到四分之一。公司还主动承认了短板:在原始能力上,像 Kimi K3 这样的前沿开源模型仍然领先,"Beam 的优势在推理阶段的效率"。换句话说,它卖的不是跑分第一,而是"同样一件事,少花算力"。
算力账单:6144 块卡预训练,10500 块卡做强化学习
据 eWeek,预训练吃掉 23.8 万亿 token 数据,跑在 6144 块英伟达 GB300 上,耗时约四周。随后是一轮同样四周的强化学习,用 10500 块 GB300,约 13 亿次沙盒评估,估算花费 2000 万到 4000 万美元。"省三到四倍算力"是 Reflection 自己的估算口径:用激活参数乘平均生成 token 数,不含提示词读取等开销——VentureBeat 明确指出这是估算而非实测。
不降价,改让模型少绕弯来降本
美国企业已在用更便宜的中国开源模型,Reflection 没加入"每百万 token 多少钱"的竞价,而是把账算到"完成一件事"上:强化学习里加了可控的长度惩罚,逼模型少写无用的思考步骤;据官方披露,模型还自发学会了浏览类技能,尽管训练数据里没有这类任务。
跑分咬得住,命令行任务仍落后
官方表里,Beam 在 SWE-bench Verified 拿 80.9、GPQA Diamond 拿 90.5,但 Terminal-Bench 2.1 的 80.1 低于 GLM-5.2 的 81.0、Kimi K3 的 88.3 和 DeepSeek V4.1 Flash 的 90.6。这些数字全是厂商自评,Epoch AI 的独立评测尚未出炉。
瞄准企业自建与主权客户
Beam 主要瞄准企业自建和主权 AI 客户:把模型放进自家机房和合规边界,不租 API。发布时已有 40 多家生态伙伴,AWS 把它放进 SageMaker JumpStart,vLLM 首日支持并宣称解码延迟降低 2.71 倍。代价是硬件门槛:自建必须把全部参数装进显存,FP8 权重约 501GB。而对英伟达来说,谁跑赢都得买它的卡。
单价优势还在中国模型手里
对照价格:DeepSeek V4 Pro 每百万输入 0.66 美元、输出 1.98 美元,Beam 则至今没公布 token 价目——"更便宜"目前还没有标价支撑,真正的检验是记录各自完成同一任务花多少 token。
公司账本:47 亿美元融资,70 亿美元算力合同
Reflection 2024 年由两位前 Google DeepMind 研究员在布鲁克林创立,累计融资 47 亿美元(英伟达出资 8 亿),4 月一轮投前估值 250 亿美元。算力端,它与 SpaceX Colossus 2 签下每月 1.5 亿美元、到 2029 年最高 63 亿美元的租约,加上 Nebius 超 10 亿美元的合同,合计锁定 70 亿美元以上算力。
独立评测尚未出炉,收购传闻尚早
拿到早期访问的 Artificial Analysis 说,Beam 是同智能水平里最省 token 的开源模型之一。10 月 10 日,英国《金融时报》报道英伟达正与 Reflection 商谈加深投资甚至收购,可能采取"人才+技术授权"形式避开冗长审查。Laskin 在 CNBC 上说,这个模型让他们进入了中国开源前沿的"射程之内"。对打算上生产线的团队,多家媒体的建议是一致的:先把每个任务实际消耗的 token 记下来,再决定换不换。
本文来源
- VentureBeat
- TechCrunch
- SiliconANGLE
- DataCamp
- eWeek